グローバルチームでシステムの変更や障害対応を行う際、「ある一箇所を修正したら、思いがけない場所で不具合が発生した」という経験はありませんか。その根本原因は、長い時間をかけて蓄積された、意図せぬインフラ依存関係、つまり「メルプアーキテクチャ」にある可能性が高いのです。この記事では、その実態を可視化し、英語を共通言語とするチームで効果的に改善するための具体的な手法を解説します。
メルプアーキテクチャがもたらす3つの隠れたリスクと英語での共有意義
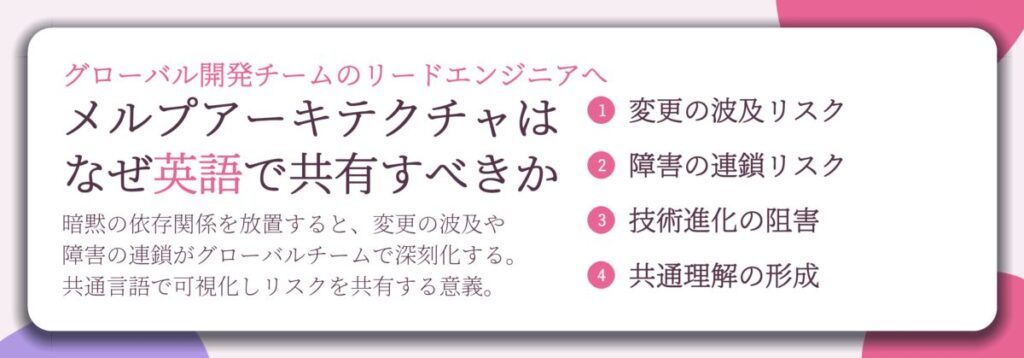
グローバルに分散した開発チームにとって、メルプアーキテクチャは単なる「複雑なシステム」以上の深刻な課題を生み出します。まずは、その本質と具体的なリスク、そして英語での共有が不可欠な理由を明らかにしていきます。
メルプアーキテクチャとは、設計上の意図ではなく、運用や機能追加の過程で自然発生した「依存の塊」を指します。例えば、複数のサービスが単一のデータベースに密結合していたり、古いシステムの特定の挙動に多くの新機能が依存していたりする状態です。計画された構造ではなく、時間とともに蓄積された「負債」という見方が近いでしょう。
メルプアーキテクチャとは何か? 単なる複雑さを超えた「依存の塊」の定義
メルプアーキテクチャは、システムの「複雑さ」という曖昧な概念を超え、「どのコンポーネントが、どのコンポーネントに、どのような理由で依存しているか」という明確な関係性の集合体と定義できます。この依存関係が文書化されておらず、関係者間で暗黙の了解となっている場合、問題は深刻化します。新しくチームに加わったメンバーや、地理的に離れたチームは、この「見えないルール」を把握するのに多大な時間を費やすことになります。
グローバルチームで無視できないリスク:変更の波及、障害の連鎖、技術的進化の阻害
メルプアーキテクチャが放置されると、以下の3つの主要なリスクが顕在化します。
- 変更の波及リスク:一見無関係な部分への修正が、依存関係を介して別のサービスに予期せぬ影響を与えます。これにより、機能追加やバグ修正のコストと時間が膨れ上がり、リリース計画が不安定になります。
- 障害の連鎖リスク:あるコンポーネントの障害が、依存関係を伝播し、システム全体の広範囲な停止を引き起こす可能性があります。障害発生時の根本原因の特定と復旧が困難になり、ビジネスへのダメージが拡大します。
- 技術的進化の阻害:古い技術やアーキテクチャに多くの機能が依存しているため、それらを新しいものに置き換えることが事実上不可能になります。結果として、技術的負債は増え続け、市場の変化に対応する敏捷性が失われていきます。
これらのリスクは、単一のローカルチームであれば経験則で何とかなることもあります。しかし、タイムゾーンや文化、言語が異なるグローバルチームでは、経験則の共有そのものが困難であり、リスクは指数関数的に高まります。
なぜ英語で可視化・共有するのか? 共通理解形成と優先順位付けの効率化
では、なぜこの「依存の塊」を、特に英語で可視化し、共有する必要があるのでしょうか。その核心は、グローバルチームにおける「共通の現実認識」の構築にあります。
依存関係図を英語で作成・共有することは、単に情報を伝達する以上の意味を持ちます。第一に、図解という視覚的媒体と、英語という共通言語を組み合わせることで、技術的な背景が異なるメンバー間でも、リスクの所在を明確に理解できます。第二に、可視化された情報を基に、改善が必要な箇所について英語で議論し、投資の優先順位を客観的に決めることが可能になります。「Aさんが言っているから」という属人的な判断ではなく、「この依存関係がビジネス継続性に与える影響はこれだけ大きい」というデータに基づいた意思決定が促進されるのです。
このセクションで焦点を当てているのは、理想的な設計を議論することではなく、「既に存在する依存関係をどう分析し、改善のための合意をグローバルチームで形成するか」という実践的な運用フェーズです。次のセクションからは、その具体的なステップと、議論で使える英語フレーズを詳しく見ていきます。
ステップバイステップで進める インフラ依存図の作成プロセス
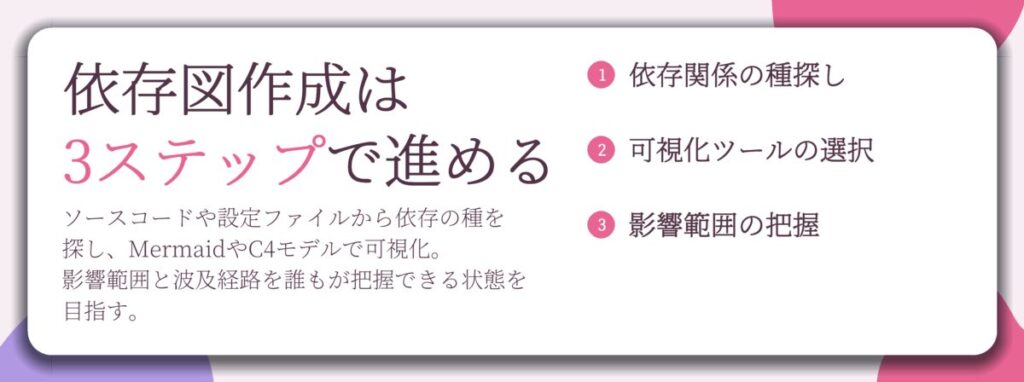
複雑に絡み合ったメルプアーキテクチャを改善するためには、まずその実態を視覚的かつ客観的に捉えることが不可欠です。ここでは、グローバルチームの誰もが理解できる、明確なインフラ依存図を作成する3つのステップを具体的に解説します。これらの手法は、ツールや環境に依存しない汎用的なアプローチです。
依存図作成のゴールは、「ある変更の影響範囲」と「障害発生の波及経路」を一目で把握できる状態にすることです。
最初のステップは、システムのどこに依存関係が潜んでいるかを多角的に調査することです。単一の情報源だけに頼ると、見落としが発生します。以下のような複数の視点から情報を収集しましょう。
- 構成管理ファイル: コンテナオーケストレーションツールのマニフェストや、インフラ構築ツールの設定ファイルには、サービス間の接続定義やネットワークポリシーが記述されています。
- アプリケーションコード: 他のサービスやデータベース、メッセージキューへのAPI呼び出し、ライブラリのインポート文などから、論理的な依存関係を発見できます。
- 監視・ログデータ: 実際のトラフィックフローやエラーログを分析すると、設計図にはない「暗黙の依存関係」が浮かび上がることがあります。
- メッセージキュー/ストリーム設定: プロデューサー(送信側)とコンシューマー(受信側)の関係は、非同期通信の重要な依存関係です。
収集した情報を整理し、図として表現します。ここで重要なのは、バージョン管理が可能で、チームでの共同編集に適した形式を選ぶことです。
テキストベースで図を定義するMermaid記法は、ソースコードと同様に差分管理ができ、レビューも容易です。以下は、単純なサービス依存を示すフローチャートの例です。
graph TD
    A[Web Frontend] --> B[User API]
    B --> C[(User Database)]
    B --> D[Payment Service]
    D --> E[(Payment DB)]
    D --> F[External Gateway]
また、システムアーキテクチャの標準的な抽象化レイヤーを提供するC4モデルを応用する方法も効果的です。インフラ依存図の作成には、「コンテナ」レベル(独立した実行環境やデータストア)や「コンポーネント」レベル(コンテナ内の主要な機能ブロック)の考え方を流用します。これにより、「アプリケーションサーバー」や「キャッシュサーバー」といったインフラ要素をノードとして明確に定義できるのです。
| ツール/手法 | 主な特徴 | インフラ依存図への適性 |
|---|---|---|
| Mermaid記法 | テキストベース、Git管理可能、共同編集向け | 高い。フローチャートやグラフで依存関係をシンプルに表現できる。 |
| グラフィカル作図ツール | ドラッグ&ドロップで直感的、視認性が高い | 中。手軽だが、バージョン管理や大規模な図の保守が難しい場合がある。 |
| C4モデルの応用 | 抽象化レイヤーが明確、視点を統一できる | 高い。インフラ要素を「コンテナ」として捉え、関係性を構造化できる。 |
図が完成したら、最後にグローバルチームでの共有を前提とした洗練を行います。多国籍メンバーが誤解なく理解するためには、図自体の表現力が鍵となります。
- すべてのノードに明確な英語ラベルを付ける: 「API Server A」ではなく、「User Management API (v2)」のように、役割と必要に応じてバージョンなどの識別子を含めます。
- 依存関係の矢印(エッジ)に意味を持たせる: 単なる線ではなく、「HTTP Request」、「Async Message」、「Database Query」といったラベルを付与し、通信の種類やプロトコルを示します。
- 「Why」を説明する簡潔な注釈を追加する: 複雑または重要な依存関係の傍らに、短い注釈ボックスを設けます。例えば、「Legacy billing system. Scheduled for decommission next quarter.」と記すことで、その依存関係の背景や将来の対応が一目で伝わります。
- 凡例(Legend)を必ず設ける: 図中で使用した記号(四角、円、破線、色など)の意味を凡例で定義します。これにより、独自のルールがチームの共通認識となります。
注釈は、事実を述べる能動態の短文が理想的です。「This cache is invalidated by the main database update event.」のように、受動態より能動態を使うと、原因と結果の関係が明確になります。技術的な略語は、初出時に簡単な説明を添えると親切です。
この3ステップを経て作成された依存図は、単なる現状の写し絵ではなく、改善議論のための強力な共通基盤となります。図を指し示しながら、「Why is this service coupled with the legacy queue?」といった具体的な対話が生まれ、メルプアーキテクチャの解消に向けた第一歩を踏み出せるのです。
依存図からアンチパターンを発見し英語で指摘する実践フレーズ集
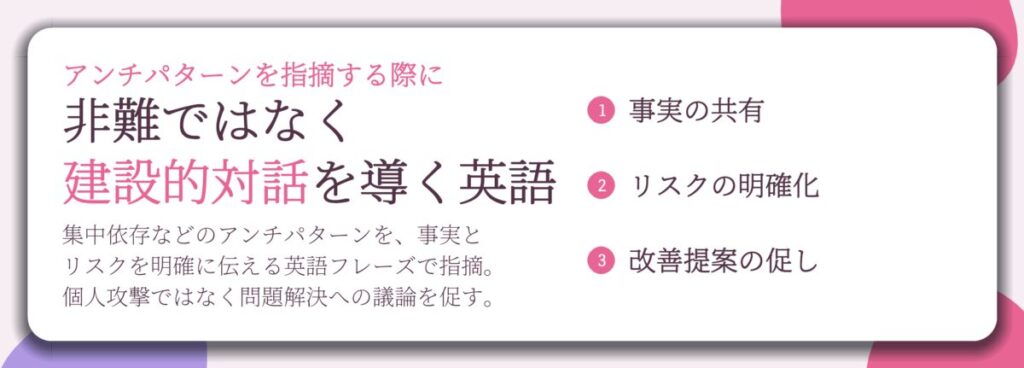
インフラ依存図は、複雑なメルプアーキテクチャを可視化するための強力なツールです。しかし、図が完成したら終わりではありません。その図をチームで共有し、問題点を特定し、改善に向けた議論を始めることが、真の目的です。このステップでは、図から発見された典型的なアンチパターンを、非難ではなく建設的な対話につなげるための英語フレーズを紹介します。
英語での議論で重要なのは、個人の責任追及ではなく、問題の客観的事実をチームで共有することです。指摘するときは「なぜその設計になったのか」という経緯より、「現在の状態が将来にどんなリスクをもたらすか」に焦点を当てましょう。
アンチパターン1:集中依存(Hub Dependency)の指摘とリスク説明フレーズ
特定のサービスやコンポーネントに多くの依存が集中している状態です。これは、その一点が障害を起こした場合に、影響がシステム全体に連鎖する「単一障害点」となるリスクをはらみます。
集中依存が見つかったら、まずは事実を共有し、潜在的なリスクを明確に伝えることが第一歩です。
- “The dependency diagram highlights that Service A acts as a hub. Three critical downstream services rely solely on it.” (依存図を見ると、サービスAがハブになっています。重要な下流サービスが3つ、そちらだけに依存しています。)
- “This creates a single point of failure. If Service A goes down, Services B, C, and D will be immediately affected.” (これは単一障害点を生み出します。サービスAが停止した場合、サービスB、C、Dはすぐに影響を受けます。)
- “From a scalability perspective, Service A could become a bottleneck as the load from dependent services increases.” (スケーラビリティの観点では、依存サービスの負荷が増えるにつれ、サービスAがボトルネックになる可能性があります。)
- “We should discuss whether this concentration is intentional or an emergent architecture that needs refactoring.” (この集中が意図的なものか、リファクタリングが必要なメルプアーキテクチャなのか、議論する必要があります。)
- “A potential mitigation could be to introduce a circuit breaker pattern or consider decoupling some of these dependencies.” (軽減策として、サーキットブレーカーパターンの導入や、一部の依存関係の分離を検討できます。)
アンチパターン2:循環依存(Circular Dependency)の特定と問題提起フレーズ
サービスAがサービスBに依存し、同時にサービスBもサービスAに依存するという、ループ状の関係です。デプロイのデッドロックや、テストの複雑化、変更の波及影響を予測不能にします。
- “We’ve identified a circular dependency between Service B and Service C in the diagram. They depend on each other.” (図の中で、サービスBとサービスCの間に循環依存を特定しました。お互いに依存し合っています。)
- “This creates a deployment deadlock. We cannot deploy one without the other being already updated, which complicates our release process.” (これによりデプロイのデッドロックが発生します。片方を更新せずにもう片方をデプロイできないため、リリースプロセスが複雑になります。)
- “Testing becomes challenging because we need to mock both services simultaneously, or deploy them together as a unit.” (両方のサービスを同時にモックするか、ユニットとして一緒にデプロイする必要があり、テストが難しくなります。)
- “To resolve this, we might need to introduce a common interface or extract shared logic into a third service.” (これを解決するには、共通インターフェースを導入するか、共有ロジックを第三のサービスに抽出する必要があるかもしれません。)
- “Can we trace back when this cycle was introduced? Understanding the history might help us find the right point to break it.” (この循環がいつ導入されたか追跡できますか? 経緯を理解することで、適切な断ち切りポイントを見つける助けになるでしょう。)
アンチパターン3:暗黙的・文書化されていない依存(Implicit Dependency)の表面化フレーズ
最も危険なパターンの一つです。設計図やコード上の明示的な依存には現れないが、実行時や特定の設定を通じて成立している関係です。例えば、別サービスのデータベースの特定値を直接参照する、共有キューや環境変数に暗黙に依存するなどが該当します。
- “Our investigation revealed an undocumented dependency where Service D reads a configuration value directly from Service E’s database table.” (調査の結果、サービスDがサービスEのデータベーステーブルから設定値を直接読み取る、文書化されていない依存関係が明らかになりました。)
- “There seems to be an implicit assumption that Service F will always be running before Service G starts, but this is not captured in our deployment scripts.” (サービスGが起動する前にサービスFが常に稼働しているという暗黙の前提があるようですが、これはデプロイスクリプトに記録されていません。)
- “This kind of hidden dependency is a major risk for troubleshooting and for new team members onboarding.” (この種の隠れた依存関係は、トラブルシューティングや新規メンバーのオンボーディングにおいて大きなリスクとなります。)
- “We should document this finding and discuss making it an explicit contract, perhaps via an API or a shared configuration service.” (この発見を文書化し、APIや共有設定サービスを介した明示的な契約に変えることを議論すべきです。)
- “Are there any other ‘tribal knowledge’ dependencies we should try to uncover and add to the diagram?” (図に追加すべき、他の「属人的な知識」に基づく依存関係は他にありますか?)
Alex (Tokyo): “Looking at the updated diagram, I’m concerned about the cluster around the ‘Notification Service’. It’s shown as a dependency for the ‘Order Service’, ‘User Service’, and ‘Billing Service’. This looks like a potential Hub Dependency.”
Sam (Singapore): “Good catch, Alex. You’re right. The diagram clearly shows it’s a single point of failure. If the Notification Service has an outage, critical user-facing functions will be impacted.”
Maria (Berlin): “Agreed. We should flag this in our backlog. Perhaps we can discuss introducing a message queue to decouple these services asynchronously. For now, let’s at least add monitoring and alerting specifically for the Notification Service’s health from the perspective of these three dependents.”
これらのフレーズを使うことで、問題を個人のミスではなく、システムの状態としてチームが認識するきっかけを作れます。指摘は常に「We(私たち)」を主語にし、次のアクション(「We should discuss…」「We might need to…」)へと自然につなげることが、グローバルチームでの建設的な改善議論の鍵です。
チームミーティングで改善策を議論し合意を形成する英語プロトコル
依存図を作成し、アンチパターンを指摘したら、次はチームでの改善議論へと移ります。ここで最も重要なのは、建設的な対話を通じて具体的な行動計画に落とし込むことです。グローバルチームでは、言語や文化の違いから意見が対立したり、結論が先延ばしにされがちです。事前準備から実行計画まで、チームの合意をスムーズに形成するための実践的な英語フレーズと手順を解説します。
議論の事前準備:依存図と問題点を共有する英語メール/ドキュメントの書き方
効果的な議論は、事前に情報を構造化して共有することから始まります。単に図を添付するだけでは、参加者間で認識のズレが生まれます。共有ドキュメントでは、事実、分析、提案を明確に分けて提示し、議論の焦点を明確にしましょう。
以下のような構成で情報を整理すると、読者が素早く状況を把握できます。
- 目的と背景 (Purpose & Context): この文書と議論の目的を簡潔に記述。
- 現在の依存関係図 (Current Dependency Map): 作成した図へのリンクまたは埋め込み。
- 特定されたアンチパターンとリスク (Identified Anti-patterns & Risks): 図から発見された問題点を列挙。それぞれに影響度(高、中、低)を付与。
- 想定される影響 (Potential Impact): 各アンチパターンがシステムの可用性、パフォーマンス、変更速度に及ぼす具体的な影響を説明。
- 議論のための質問 (Questions for Discussion): ミーティングで話し合いたい具体的な問いをリストアップ。
メールやチャットで議論を招集する際は、この文書を参照しながら、次のようなフレーズが使えます。
- “I’ve created a summary document outlining the key dependency risks in our current architecture. Please review it before our meeting on [Day].”
- “The goal of this session is to prioritize the identified issues and agree on actionable next steps.”
- “Particularly, I’d like us to focus on the high-risk dependency between Service A and the monolithic database.”
ミーティング進行:建設的な議論を促すファシリテーション英語フレーズ
ミーティングでは、議論が脱線したり、特定のメンバーだけが発言するのを防ぎ、全員が建設的に参加できる環境を作ることがファシリテーターの役割です。以下のフレーズを状況に応じて使い分けましょう。
- 議論の焦点を定める: “Let’s focus on the highest-risk dependency first. What are our options to decouple Service A?”
- 全員の意見を求める: “We’ve heard from the frontend team. I’d like to get the infrastructure team’s perspective on this.”
- アイデアを整理する: “So, if I understand correctly, we have two main proposals: creating an abstraction layer or implementing a circuit breaker. Is that right?”
- 反対意見を建設的に扱う: “That’s a valid concern about the development cost. How might we mitigate that while still addressing the risk?”
- 合意に向けて確認する: “It sounds like we’re leaning towards starting with the abstraction layer. Does anyone have strong objections to this direction?”
「Yes/No」で答えられる質問ではなく、「How(どのように)」「What(何を)」で始まるオープンクエスチョンを多用することが、深い議論を引き出すコツです。
合意形成とアクションアイテム設定:責任の明確化と次回レビュー日程の提案フレーズ
議論が収束したら、曖昧さを残さず具体的な行動計画に落とし込みます。アクションアイテムは「誰が」「何を」「いつまでに」の3要素を必ず含め、全員の認識を一致させましょう。
| アクション (Action) | 所有者 (Owner) | 期限 (Due Date) | 目標 (Goal) |
|---|---|---|---|
| Design the abstraction layer interface for Service A | Alex (Backend Team) | End of next sprint | Reduce direct DB dependency |
| Implement a basic circuit breaker for the payment service call | Sam (Platform Team) | Two weeks from now | Improve system resilience |
| Schedule a ‘Dependency Refactoring Sprint’ | Facilitator (You) | This Friday | Plan incremental improvements |
ミーティングの終盤では、次のようなフレーズで合意を確認し、アクションを設定します。
- “To summarize our agreement, we will proceed with designing an abstraction layer as the first step, with Alex leading the design.”
- “Let’s document these action items in our project tracker. I’ll send a follow-up email with the minutes and the agreed list.”
- “I propose we review the progress of these items in our next architecture sync, two weeks from today. Does that work for everyone?”
大規模な依存関係の改善は、一度に全てを変えようとすると挫折します。代わりに、小さな改善を継続的に行う「依存関係リファクタリングスプリント」を提案しましょう。これは通常の開発スプリントの中に、例えば「四半期に1スプリント」や「全チームメンバーの10パーセントの工数を毎スプリント確保する」といった形で組み込む計画です。
- 提案フレーズ: “To sustainably pay down our architectural debt, I suggest we institutionalize a ‘Dependency Refactoring Sprint’ every quarter, dedicated solely to decoupling and resilience improvements.”
- 利点の説明: “This approach allows us to make continuous, low-risk progress without blocking feature development.”
このプロトコルに従うことで、単なる問題の指摘を超えて、グローバルチームが一体となってアーキテクチャを改善する実行力へと変換できます。明確な事前共有、建設的なファシリテーション、具体性のあるアクション設定が、成功の鍵です。
継続的な監視と予防 メルプアーキテクチャの再発を防ぐプラクティス
依存図を作成し、問題を特定しても、改善策の実行だけで終わってはいけません。一度整理されたアーキテクチャも、日々の開発の中で無秩序な依存関係が再び忍び込む危険があります。真の目的は一時的な修正ではなく、依存関係の複雑化を予防し、管理可能な状態を維持する文化を築くことです。このセクションでは、改善の成果を持続させるための継続的なプラクティスを紹介します。
依存関係の「健康診断」を定期的に行うプロセス設計
複雑化を防ぐ最も効果的な方法は、定期的なレビューをプロセスに組み込むことです。多くのチームでは、四半期ごとに「インフラ依存関係レビュー」と呼ばれるミーティングを制度化しています。この会議の目的は、最新の依存図を基に、新たに追加された接続や、依存の深さが増した部分をチームで確認することです。
- 依存図の更新を、四半期の開発サイクルの終わりに組み込む。
- 更新された図を事前にチームに共有し、レビューの議題を明確にする。
- レビューミーティングでは、新規・変更された依存関係に焦点を当て、それが当初の設計原則に沿っているかを議論する。
- 問題が発見された場合、小さな改善タスクとして次の四半期のバックログに登録する。
この定期的な「健康診断」により、問題が大きくなる前に発見し、技術的負債として蓄積する前に解消する習慣が身につきます。
新規サービス・インフラ追加時のレビューチェックリスト(英語版)
定期的なレビューに加え、新規要素を追加する際のゲートを設けることが重要です。開発者が新しいサービスやデータベースを追加する前に、以下のようなチェックリストを通過させることを求めます。これは、英語で記述することでグローバルチームの共通認識を強化します。
- Does the new service introduce a direct dependency on a non-highly available (non-HA) database? (新しいサービスは、高可用性でないデータベースへの直接依存を生みますか?)
- Is there an existing service that already provides similar functionality? (同様の機能を既に提供しているサービスは存在しますか?)
- Are we creating a new synchronous call to a critical path service? (クリティカルパスのサービスへの新たな同期呼び出しを作成していませんか?)
- Have we documented this new dependency in the central architecture diagram? (この新しい依存関係を中央のアーキテクチャ図に文書化しましたか?)
- Can this communication be made asynchronous (e.g., via a message queue) instead of synchronous? (この通信は、同期ではなく非同期(メッセージキュー経由など)に変更できますか?)
このチェックリストは、開発者が設計段階で依存関係の影響を考えるきっかけとなり、問題のあるパターンの侵入を未然に防ぎます。
プラットフォームチームの役割:標準化された接続パターンとガイドラインの提供
チェックリストで「やってはいけないこと」を指摘するだけでは不十分です。開発チームに、より良い選択肢となる「道」を提供するのが、プラットフォームチームやアーキテクチャーチームの重要な役割です。
具体的には、以下のような標準化されたパターンとツールを整備し、推奨します。
- サービスメッシュの活用: サービス間通信の安全性、可観測性、ルーティングを中央管理し、各サービスが個別に通信ロジックを実装する負担を減らします。
- 標準化されたAPIゲートウェイパターン: 外部からのリクエストは必ずAPIゲートウェイを経由させ、内部サービスへの直接アクセスを防ぎます。認証・認可などの横断的関心事もここで集中処理します。
- 非同期通信(メッセージキュー/イベント駆動)の推奨: サービス間の結合度を下げ、システム全体の回復性を高めるためのライブラリ、テンプレート、ベストプラクティスガイドを提供します。
- 依存図の自動生成とCI/CDパイプラインへの統合: コードの変更が依存図に自動的に反映され、プルリクエスト時に依存関係の変化を可視化する仕組みを作ります。
プラットフォームチームの目標は、開発者が「正しい方法」で簡単に開発できる環境を整備することです。制限ではなく、ガイドラインとツールによる支援が鍵となります。
- 小さな成功から始める: いきなり全システムを対象にせず、一つの重要なサービス群から定期レビューを始め、その価値を示します。
- 可視化の成果を共有する: 依存図を整理することでインシデント対応が早くなった、変更の影響調査が楽になったなどの具体的なメリットをチームで共有します。
- 「依存関係の可視化と管理」をチームの価値観に組み込む: 新メンバーのオンボーディング資料や、プロジェクトの成功基準の一つにこの考え方を加えます。
- ツールとプロセスを進化させる: 定期レビューでのフィードバックを元に、チェックリストやプラットフォームの提供物を改善し続けます。
メルプアーキテクチャの管理は、一度きりのプロジェクトではなく、継続的な習慣です。定期的なレビュー、事前のチェック、そしてより良い選択肢の提供。この三つの柱を確立することで、複雑さの再発を防ぎ、システムの長期的な健全性と開発速度を両立させることができます。