英語学習の効率を劇的に変えるカギは、あなたが意識していない「無意識の情報フィルター」を書き換えることにあります。学習中、脳は膨大な情報のうち「これだけ」と選別し、残りをシャットアウトしています。このフィルターが最適化されていないと、重要な学習情報までもが「雑音」として捨てられ、努力の大部分が無駄になってしまうのです。
あなたの目と耳は『何を見て、何を聞いていない』のか 学習情報に対する無意識の選別プロセスを可視化する
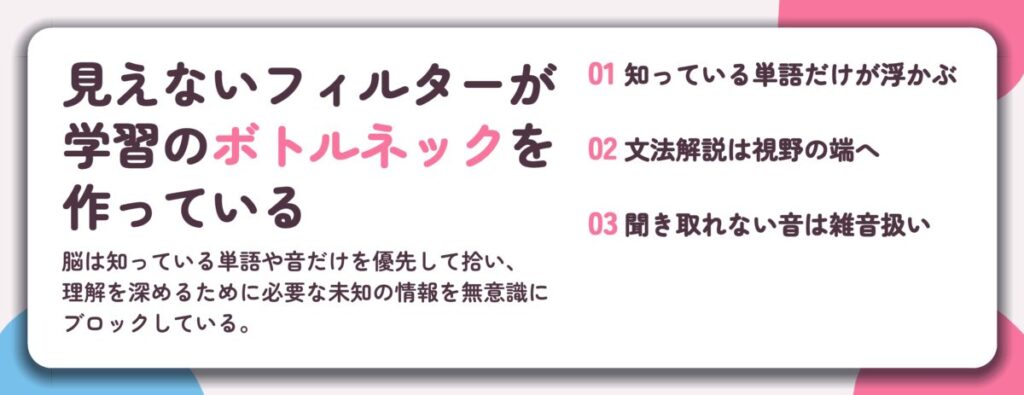
英語のテキストを読んだり、音声を聞いたりするとき、あなたの脳は高速で情報の取捨選択を行っています。このプロセスはあまりに自動的で、自分が何を「見落とし」、何を「聞き逃している」のか気づくことは困難です。まずは、この隠れたフィルターの正体を理解することから始めましょう。
「知っている単語」だけが浮かび上がる 英語テキストを読む時の視覚的選択性
リーディングでは、視線がテキスト上を移動する際、すべての単語や文法構造を均等に認識しているわけではありません。脳は「知っている単語」や「見慣れた語順」を優先的に拾い上げ、「未知の単語」や「複雑な文法解説」には、意識が向きにくい傾向があります。
あなたは文法解説と例文、どちらにより長く目が留まりますか?
次の英文と解説が並んだ文章を、いつも通りに読んでみてください。その後、目を閉じて、最初に思い浮かぶのは「解説の内容」ですか、それとも「例文そのもの」ですか? 多くの学習者は、意味が取れる例文の方に強く引かれ、その背景にある文法ルールの説明は、視野の端に追いやられてしまいます。
この「視覚的注意の偏り」が、文法理解の浅さや、知識の応用が利かない原因のひとつです。フィルターが「理解できる情報」だけを通過させ、理解を深めるために必要な「難しい情報」をブロックしている状態です。
「聞き取れない音」は最初から聴覚の門前払い リスニング時の音声入力レベルの選別
リスニングにおいても、同様の選別が起きています。ネイティブの自然なスピードで流れてくる音声の連続体から、脳は「単語の切れ目」や「知っている音」を無意識に探します。その結果、「子音の脱落」や「音の連結」といった、日本語にはない音声変化は、初期段階で「雑音」または「聞く必要のない音」として処理され、意識に上がる前に捨てられてしまうのです。
- 耳がすべての音を物理的に受け取る。
- 脳が「これは英語の音か?」「知っている単語の音か?」を瞬時にフィルタリング。
- フィルターを通らない音(例:連結した音、弱く発音された前置詞)は「無意味な雑音」として捨てられる。
- 通過した音だけが「聞き取れた音」として意識に上り、意味理解のプロセスへ。
つまり、「聞き取れない」のではなく、「聞き取る前に、聞く対象から外している」状態が頻繁に発生しているのです。このフィルターの存在に気づかず、ただ漫然とリスニング教材を聞き流しても、フィルターがブロックする音は永遠に聞こえるようにはなりません。
情報フィルターが学習効率に与える影響を図解で理解する
これらの前意識的な選別プロセスが、どのように学習のボトルネックを生み出すのか、以下の比較を通じて理解を深めましょう。
| 学習者の状態 | 脳内の情報フィルター設定 | 通過する情報 | ブロックされる情報 | 結果としての学習効率 |
|---|---|---|---|---|
| Before: 最適化前 | 「快適ゾーン」優先 知っているもの・楽なものを通過させる | 既知の単語 簡単な例文 はっきり発音された単語 | 新しい文法解説 複雑な構文 音声変化(連結・脱落) | 努力の割に伸び悩む 応用力がつかない リスニングの壁を感じる |
| After: 最適化後 | 「学習ゾーン」認識 未知・困難な情報を積極的に捕捉 | 既知の情報 + 新しい文法ルール 音声変化のパターン | 無関係な雑音(本当の雑音) | インプットの質と量が向上 理解の深度が増す 総合的な能力が底上げされる |
無意識のフィルターが「快適ゾーン」の情報ばかりを選んでいると、学習は常に既知の範囲内で堂々巡りし、新しい知識や技能はなかなか定着しません。これが、多くの学習者が感じる「学習の壁」や「伸び悩み」の核心的な原因の一つです。
次のセクションでは、この「無意識の情報フィルター」を具体的にどう書き換え、学習効率を3倍に高めるための実践的な手法を詳しく解説していきます。まずは、自分自身のフィルターが今、どのような設定になっているのかを客観的に認識することが、すべての第一歩です。
3つの診断テストであなたの脳内フィルターの癖を特定する
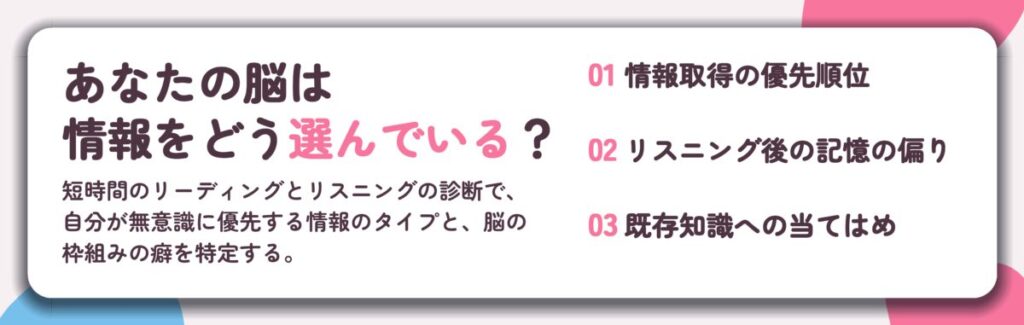
英語を読んだり聞いたりするとき、あなたの脳はどのように情報を選別しているのでしょうか。そのプロセスを具体的なテストを通して可視化します。以下の3つの簡易診断であなたの「無意識の情報フィルター」にどんな癖があるのかを明らかにしましょう。
同じ英文を読んでも、語彙力が同程度の人でも注目点が異なります。リスニング後の記憶は「内容」か「不明な単語」か「音の雰囲気」のどれに偏っているでしょうか。新しい概念を既存知識の枠組みに無理やり当てはめようとする脳の傾向を確認します。これらを知ることで、あなたの学習効率を下げているフィルターの癖を見つけ出せます。
診断A:限られた時間で英文記事から何を読み取るか 『情報取得の優先順位』テスト
まずは、あなたの「読み取り方の優先順位」を確認します。以下の英文を、30秒間だけ読んでください。タイマーを設定するか、時計を見ながら読み始めてください。
“Effective communication in a remote team hinges not only on the clarity of the message but also on the frequency and predictability of updates. A study involving distributed software developers found that teams with scheduled, brief daily check-ins reported 40% fewer misunderstandings and felt more connected than those relying solely on ad-hoc communication.”
時間を制限することで、あなたの脳が「これだけは」と判断して優先的にキャッチする情報が浮かび上がります。無意識のフィルターの働きを捉えるためです。
30秒が経ちました。次に、以下の質問に答えてください。最も強く印象に残ったもの、あるいは最初に目が行ったものを選びましょう。
| 質問 | 選択肢 |
|---|---|
| 1. この文章で最も注目したのは? | A. 「remote team」「distributed software developers」といった「誰が」に関する語句 B. 「40% fewer misunderstandings」といった具体的な「数値や結果」 C. 「clarity」「frequency」「predictability」といった「抽象的な概念や条件」 D. 知らない単語や、読みづらいと感じた文法構造 |
| 2. 文章を読んだ後、あなたが誰かに説明するとしたら、最初に口にするのは? | A. 「リモートチームのコミュニケーションについての話だよ」 B. 「毎日少しでも連絡を取るチームは、誤解が40%減ったんだって」 C. 「メッセージの明確さより、更新の頻度と予測可能性が大事らしい」 D. 「ちょっと難しい単語があったな…」 |
あなたの選択結果はメモしておきましょう。後で結果を総合的に解釈します。
診断B:ネイティブ音声を聞いた直後の記憶に残るもの 『音声情報の残存パターン』テスト
次に、リスニング時のフィルターを診断します。以下の日本語のシチュエーションを想像しながら読んで、その後に質問に答えてください。
「あなたはオンライン会議に参加しています。英語のネイティブスピーカーが、先ほどの英文をもとに、さらに詳しい事例を話し始めました。そのスピーチを一度だけ聞きました。」
実際の音声は流しません。多くの学習者が経験する「音声を聞いた直後の頭の中の状態」を思い出し、そこに残っている情報の種類を特定することが目的です。
音声が終わった直後、あなたの頭の中に最も強く残っている感覚は、次のどれに近いでしょうか。
- パターン1(内容重視型):話の大筋(「定期的な連絡の重要性」)は追えた気がするが、細かい単語や数字はあやふや。
- パターン2(単語追跡型):「hinges on…?」「ad-hocって何だっけ?」など、聞き取れなかったり意味が分からなかった単語がいくつか頭にこびりついている。
- パターン3(音声処理型):内容よりも、話者の早口な感じやアクセント、リズムの印象が強い。あるいは「音は聞こえたけど、意味に結びつかなかった」という感覚。
どのパターンが最もしっくり来るか、あるいは複数当てはまるかを確認してください。
診断C:新しい文法解説を読んだ時の理解のプロセス 『未知情報の解釈バイアス』テスト
最後は、新しい知識を学ぶときの脳のクセを探ります。以下の「架空の文法用語」とその説明を読んで、あなたがどう理解しようとするか観察してください。
用語:Post-positive Modal Clustering
説明:これは、話し手が発言の直後に、その内容に対する自身の確信度や感情を付加的に示す言語現象を指します。主に会話において、文の主要な意味が伝わった後で、「…かもしれない」「…だと思う」といったニュアンスを短い句で後置するパターンです。
この説明を読んだとき、あなたの頭の中で最初に起こったことは次のどれですか。
- A. 既知の知識への当てはめ:「ああ、『付加疑問文(Tag Question)』みたいなものかな?」「『I think…』のバリエーション?」と、知っている文法用語に結びつけようとした。
- B. 具体例の要求:「具体的にどんな英文になるんだろう?」と、すぐに例文が欲しくなった。抽象的な説明だけではピンと来ない。
- C. 用語そのものの分析:「Post-positiveって『後置の』だな」「Clusteringは『集団化』か」と、用語を構成する単語から意味を推測しようとした。
- D. 必要性の疑問:「これは本当に必要な概念なのか?」「いつ使うんだ?」と、その有用性を最初に確認したくなった。
脳は新しい情報に出会うと、それを既存の知識の引き出しに無理やり収めようとします。これは理解を早める一方で、概念の本質的な新しさを見落とし、誤解を生む原因にもなります。あなたの最初の反応が、この「解釈バイアス」の傾向を示しています。
診断結果の解釈表:あなたのフィルターの癖とその影響
3つの診断であなたが選んだ傾向を、以下の表で照らし合わせてみましょう。あなたの無意識のフィルターが、どのように学習情報を選別しているのかが見えてきます。
| 主な傾向 | 診断A(読解)での特徴 | 診断B(聴解)での特徴 | 診断C(理解)での特徴 | 学習への影響 |
|---|---|---|---|---|
| 大局・文脈重視型 | AやCを選択。全体のテーマや抽象概念をまず捉えようとする。 | パターン1(内容重視型)。細部より話の流れを追う。 | B(具体例要求)に近い。文脈がないと理解しづらい。 | 長文読解やディスカッション理解は得意だが、細かい文法や語彙の正確さがおろそかになりがち。 |
| 細部・正確性追求型 | B(数値)やD(未知語)を強く選択。具体的で検証可能な情報や障害に注目。 | パターン2(単語追跡型)。聞き取れない語が気になって先に進めない。 | C(用語分析)やA(既知知識への当てはめ)。定義や構造を厳密に把握しようとする。 | 文法や単語の知識は正確だが、スピードが要求される場面や、あいまいなニュアンスの理解に苦労することがある。 |
| 音声・感覚処理型 | 特に関連が薄いが、読みにくさ(D)を「リズムが悪い」と感じる場合がある。 | パターン3(音声処理型)が強く当てはまる。音そのものへの意識が強い。 | D(必要性の疑問)に近い。「どう聞こえるか」「どう使うか」という実用面から理解しようとする。 | 発音やイントネーションの模倣は上手いが、文字情報からの学習や、文法理論の理解がやや弱い傾向がある。 |
この診断結果は「良い・悪い」を判断するものではありません。重要なのは、あなたが今、どのフィルターを通して英語情報を見ているのかを自覚することです。例えば、細部追求型のフィルターが強い人がリスニング学習をする場合、聞き取れない単語一つひとつに引っかかり、全体の内容を聞き流す練習が不足するかもしれません。逆に大局重視型の人が文法書を読むと、大まかな概念で理解した気になり、実際に使える正確な知識として定着しない恐れがあります。
次のセクションでは、ここで特定したあなたの「フィルターの癖」を、学習目的に合わせて最適化していく具体的な方法を解説します。自分に足りていない情報の取り込み方を意識的に鍛えることで、学習効率は確実に向上します。
認知のハードウェアに介入する 無意識のフィルターを書き換える4段階の実践トレーニング
診断結果から見えた「見落とし」「聞き逃し」の癖は、変えられます。ここからは、あなたの認知プロセスそのものに働きかけ、学習効率を高めるフィルターを構築する具体的なトレーニングを紹介します。この4段階のステップは、脳が情報を処理するハードウェアに直接介入し、自動化された選別アルゴリズムを書き換えることを目指します。
学習中の「視野」「解像度」「関連付け」「自動化」という四つの認知機能を段階的に強化し、重要な情報が自然に拾える脳内環境を整えます。
第一段階:『入力の拡張』 視野と聴覚の焦点を意図的にずらす練習
まずは、情報の捉え方そのものを広げます。多くの学習者は、英文を読むとき「次の単語」、音声を聞くとき「知っている単語」にだけ意識が向きがちです。この段階では、意識の焦点を意図的にずらすことで、視野と聴野を広げる練習をします。
単語ではなく、意味の塊(チャンク)で見る・聞く
リーディングでは、単語を一つずつ追うのをやめ、「名詞句」や「動詞句」といった意味の塊(チャンク)単位で視覚をスキャンします。例えば、次の文を単語単位ではなく、下線部のようなチャンクで捉えてみましょう。
| Before (単語追い) | After (チャンク視認) |
|---|---|
| The / quick / brown / fox / jumps / over / the / lazy / dog . | The quick brown fox / jumps over / the lazy dog. |
リスニングでは、意味のわかる「キーワード」だけを拾おうとする癖を緩めます。代わりに、前置詞(in, at, for)や接続詞(and, but, because)、冠詞(a, the)などの「機能語」や、単語同士がつながって変化する「音声変化」に耳を傾けます。これらの要素は文の骨格と流れを示しており、捉えられると全体の理解が飛躍的に向上します。
- 英文を1行見て、すぐに目を逸らす。
- 頭の中で、目に飛び込んできた「塊」を思い浮かべる(例: a large black cat / sitting on / the sunny windowsill)。
- 細かい単語は思い出せなくても構わない。意味の塊が何個あったかを確認する。
- 短い音声(1文程度)を聞き、意味ではなく「音のつながり」に集中する。
- 「want to」が「wanna」に聞こえるなど、音声変化した箇所を探す。
- 機能語(a, the, of)がどのように発音されているかに注目する。
第二段階:『解像度の向上』 これまでスルーしていた情報の細部に注目する方法
入力が広がったら、次はその質を高めます。第一段階で「塊」として捉えられた情報の中に、さらに細かいが重要な要素が隠れています。これを意識的に拾い上げるトレーニングです。
例えば、動詞の「時制」や「態(能動・受動)」、名詞の「可算・不可算」、前置詞の「ニュアンスの違い」などです。これらは、文の正確な意味や筆者の意図を伝える重要な信号ですが、多くの学習者のフィルターでは「雑音」として処理されがちです。
文「I have lived here for 5 years.」を見たとき、単に「私は5年間ここに住んでいる」と訳すだけでなく、「have lived」という現在完了形が「過去から現在までの継続」を表している点に注目します。また、「for 5 years」の「for」が「期間」を表す前置詞であることも確認します。これが「解像度」です。
第三段階:『関連付けの最適化』 新しい情報と既存知識を結びつける神経回路の強化
高解像度で捉えた情報は、脳内で孤立したままではすぐに忘れられます。これを防ぎ、長期記憶に定着させるためには、新しい情報と、すでに知っている知識を積極的に関連付ける思考のクセが必要です。
新しい英単語「frugal(倹約な)」を学んだとします。この時、単に「倹約な=frugal」と暗記するのではなく、以下のような関連付けを同時に行います。
- 類義語・反義語: thrifty(倹約な)とはどう違う? wasteful(浪費的な)の反対だ。
- イメージやエピソード: 祖父はとてもfrugalな人で、何でも最後まで使った。
- 文脈での使用例: She leads a frugal lifestyle to save for her travels.(彼女は旅行のために倹約した生活を送っている)
- 文法との結びつき: 「frugal with money」(お金に倹約な)のように「with」を伴うことが多い。
このように、一つの情報点を、複数の既存知識ネットワークに結びつけることで、想起(思い出す)が容易になり、応用も利くようになります。脳内で情報が「点」から「線」「面」へと成長する感覚です。
第四段階:『自動化』 最適化されたフィルターを日常学習に定着させるルーティン設計
最後は、これまで意識的に行ってきた拡張・向上・最適化のプロセスを、無意識の習慣に落とし込みます。毎日の学習に組み込むことで、最適化されたフィルターが自動的に働く状態を目指します。
- 朝のスキャン: ニュースサイトの見出しを1つ、チャンク単位で素早く読み、主語と動詞の塊を特定する(1分)。
- 通勤中の焦点リスニング: ポッドキャストを聞き、機能語(and, but, the)だけに意識を向けてみる(2分)。
- 夜の1語深堀り: その日新しく出会った単語を1つ選び、類義語とコロケーションを辞書で調べ、関連付けてノートにメモする(2分)。
このルーティンの核心は「量」ではなく「質」と「継続」にあります。毎日短時間でも、最適化されたフィルターを使う機会を設けることで、脳はそれを標準的な処理プロセスとして採用し始めます。やがて、英文を読むとき、音声を聞くとき、新しい表現を学ぶときに、これらのステップが自動的に起動するようになるでしょう。
四つの段階は独立しているわけではなく、相互に作用します。関連付けが上手くなれば、細部への注目も自然と増えます。日常的に実践することで、あなたの脳は「学習に最適化された情報フィルター」へとアップデートされていきます。
目的別フィルター設定例 試験対策・会話力向上・多読で最適化すべき情報選別の焦点
あなたの学習目的に合わせて、脳内フィルターの設定を最適化しましょう。同じ英語の音声や文章でも、目指すゴールによって注視すべき情報の焦点はまるで違います。ここでは、主要な3つの学習目的に応じた具体的なフィルター設定法と、日常でのトレーニング方法を紹介します。あなたの目的に合ったフィルターを構築することで、学習素材から吸収できる情報量が飛躍的に増えます。
TOEICスコアアップを目指す人のための『時間効率と正答直結型』フィルター
限られた試験時間内で正答率を上げるには、解答に直接関係ない情報を素早く切り捨てるフィルターが必須です。リーディングでは、段落の最初と最後の文、接続副詞(However, Therefore)、比較表現に自動的に注意を向けるようにします。リスニングでは、設問で問われそうな「誰が」「いつ」「どこで」「何をした」といった要素を予測しながら聞く習慣をつけましょう。
| 目的 | 最適化ポイント | 具体的アクション |
|---|---|---|
| 時間内の正答率向上 | 解答に直結する情報のみを抽出 | パッセージの先頭/末尾文、設問のキーワードに目を走らせる |
| リスニングの聞き逃し防止 | 5W1Hの要素を追跡 | 会話音声を聞く前に、登場人物と場所を予想する |
| 選択肢の迷いを減らす | 明らかな誤答を瞬時に除外 | 選択肢の中から、本文にない情報を含むものを先に削る |
練習素材例: 模試や公式問題集のパート7長文。まず30秒で設問を読み、次に1分で本文から答えの根拠となる部分だけを探す練習を繰り返します。
このフィルターは試験対策に特化したものです。英文を味わったり、深く理解したりする力は養われません。あくまで時間制限のあるテストでのパフォーマンス向上が目的であることを忘れないでください。
自然な英会話力を身につけたい人のための『文脈と感情のニュアンス』優先フィルター
自然な会話を理解するには、単語の辞書的な意味以上に、話し手の意図や感情、相手との関係性を読み取る必要があります。このフィルターは、声のトーン、間の取り方、フィラー(well, you know)、省略形などを重要な情報として拾い上げます。文字情報に頼れない分、非言語的な手がかりに敏感になることが鍵です。
- まずは「何を言ったか」より「どう言ったか」に集中する。嬉しそうな声か、困った声か。
- 頻出するフレーズの「型」を覚える。例えば、提案は “Why don’t we…?”、同意は “That makes sense.” といったパターン。
- 会話の流れ(相槌→質問→回答→補足)を把握し、次に来る発話を予測する練習をする。
練習素材例: 海外ドラマや映画の一場面。音声だけを聞き、登場人物が怒っているのか、からかっているのか、真剣なのかを、言葉以外の要素から推測してみましょう。
英文多読で語感を養いたい人のための『パターンとコロケーション』抽出フィルター
多読の目的は語彙を増やすだけでなく、英語の自然なリズムや単語の結びつき(コロケーション)を体に染み込ませることです。このフィルターは、個々の未知語にこだわらず、文全体の骨格(主語・動詞・目的語の流れ)や、頻出する「形容詞+名詞」「動詞+前置詞」の組み合わせを無意識に抽出するように設計します。
まずは1パラグラフを、細部を気にせずに最後まで読み通します。主語と動詞の関係、話の展開方向(時系列、対比、具体例)を把握することを優先します。
2回目に読むとき、気になる構文(It is … that …)や、よく一緒に出てくる単語のペア(make a decision, heavy rain)に軽くマークしたり、心の中で繰り返したりします。
文脈と既知の単語から、未知語のおおよその意味を推測します。推測したら、そのまま読み進め、辞書は後回しにします。
この読み方を続けると、英語の情報が単語単位ではなく、意味のまとまり(チャンク)で頭に入ってくるようになります。結果として、読解速度と理解度が同時に向上していきます。
フィルター書き換えの落とし穴と効果を持続させるためのメンテナンス法
新しい情報フィルターの使用に慣れ、学習が進むにつれて、新たな課題が現れます。それは、書き換えたフィルターそのものが今度は「固定化」し、偏りを生む可能性です。最適化された情報選別能力を活かし続けるためには、定期的なメンテナンスと微調整が不可欠です。
「意識しすぎ」による情報処理のパンクを防ぐ方法
新しいフィルターを意識的に運用し始めたばかりの頃は、それ自体が大きな負担になることがあります。すべての英語の音声や文章を「今、私は正しくフィルタリングできているか」と逐一チェックする状態は、脳の情報処理容量を圧迫し、学習そのものを疲れさせる原因です。
この状態は、脳が古い自動処理から新しい自動処理へ移行する過程で必ず起こる一時的な現象です。これを防ごうとするのではなく、上手に付き合うことが重要です。
具体的には、1日の学習時間のうち、最初の5分から10分だけを「意識的フィルタリングモード」に設定します。その時間は、学習素材に対して「今、自分はどの情報を拾い、どの情報を捨てているか」を言語化する練習をします。その後は、その設定を信じて自動化に任せ、学習内容そのものに集中するように切り替えます。このオンとオフの切り替えが、負担を軽減し、新しいフィルターの定着を助けます。
学習が進むと再び現れる新たなフィルターの偏りとその調整
中級から上級へと進むにつれて、今度は最適化したフィルター自体が「当たり前」になり、その枠組み内でしか情報を選別できなくなるリスクがあります。例えば、ある試験のリスニング対策で「設問のキーワードを先読みして聴く」フィルターが完全に自動化されると、会話全体の流れや話者の感情といった、より高次の情報を拾えなくなる可能性があります。
定期的なセルフチェックのポイント
- 最近、同じ種類の間違い(例:前置詞の聞き逃し、長文の主旨の取り違え)を繰り返していないか。
- 自分の理解が「表面的」になっていないか。内容を要約したり、別の言葉で言い換えたりできるか。
- 学習目的(試験対策から会話力向上など)が変わったのに、フィルター設定は古いままになっていないか。
これらのチェックで「偏り」が疑われる場合は、目的に合わせてフィルターの焦点を微調整します。試験対策から会話力へシフトするなら、「正確な単語」から「話の大筋と話者の意図」へ注目点を移すといった具合です。
最適化された情報選別能力を他の学習スキルに統合する
リスニングやリーディングで磨いた情報選別能力は、アウトプットであるスピーキングやライティングにも応用できます。入力時に「重要な情報は何か」を瞬時に判断できる脳は、出力時にも「伝えるべき核心は何か」を優先して言語化する傾向が強まります。
英文を読む・聞く際、「この文の幹(主語・動詞・目的語)は何か」「筆者・話者の一番言いたいことはどこか」を常に探す習慣を維持します。
自分が英語で話す・書くときは、その「一番言いたい核心」を最初に置くことを意識します。枝葉の情報は後から追加します。
作成した英文を、後から「核心が明確か」「冗長な部分はないか」と自分でチェックしたり、フィードバックをもらったりします。
このように、入力(インプット)の質の向上が、自然と出力(アウトプット)の構造化と明確さにつながるのです。脳内フィルターの最適化は、単なる情報の取捨選択を超え、英語を使った思考そのものの効率化をもたらします。