英語のスピーキングで言葉に詰まるのは、あなたの知識が足りないからではありません。多くの場合、「知っていること」と「瞬間的に言えること」の間に、脳内での検索や変換の遅れが生じているからです。このセクションでは、その遅延の正体と、それを劇的に短縮する「脳内キャッシュ」という考え方を学んでいきます。
なぜ知識があっても言葉が出てこないのか? 脳内の「検索エンジン」の仕組みを理解する
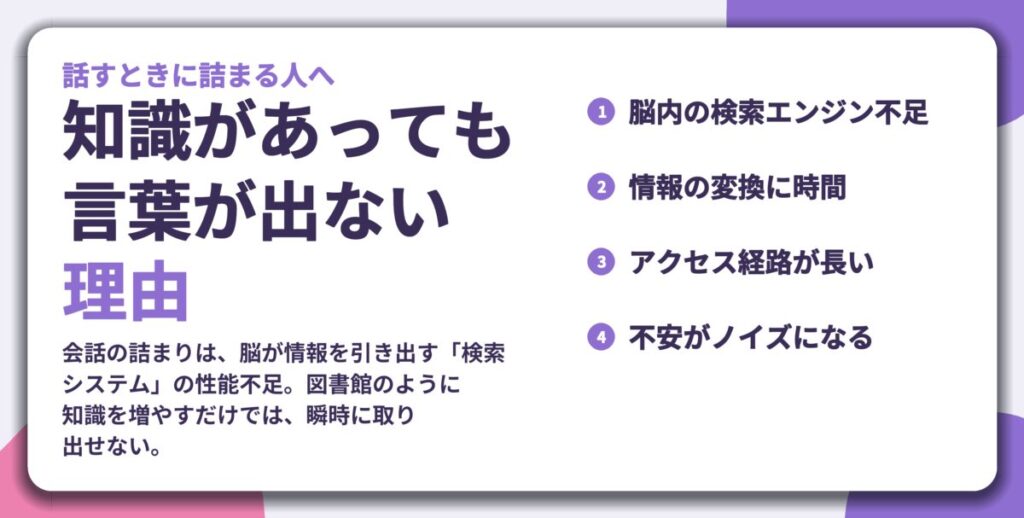
単語帳や文法書を覚え、リスニングの学習も積んでいるのに、いざ話す場面になると言葉が引っかかってしまう。これは、脳が情報を引き出すシステムにボトルネックがあるからです。学習で「知識」を増やすことと、会話で「知識」を瞬時に使うことは、脳にとって異なるプロセスなのです。
あなたの脳は「図書館」か「検索エンジン」か?
従来の英語学習は、脳を「図書館」のように扱ってきました。単語や文法ルールという「本」を、記憶という「書架」に丁寧に並べていく作業です。このアプローチでは、蔵書が増えれば増えるほど、会話の場面で目的の一冊を探し出すのに時間がかかります。
一方、流暢なスピーキングを実現する脳は、高性能な「検索エンジン」の役割を果たします。膨大な情報の中から、会話の文脈に最適な表現を、ほんの一瞬で見つけ出し、提示することが求められます。問題は、多くの学習者が「図書館」の蔵書を増やすことに注力する一方で、「検索エンジン」の性能を高めるためのトレーニングをしていない点にあります。
従来の学習: 「蔵書(知識)を増やす」作業。単語や文法を記憶の奥深くにストックする。
本稿のアプローチ: 「検索システムを構築する」作業。会話で最も使う情報を、すぐ手の届く場所に配置する。
スピーキングが詰まる3つの認知ボトルネック
会話中に「えーっと…」と詰まってしまう瞬間、あなたの脳内では主に3つの段階で処理の遅延が発生しています。
- 情報の変換: 頭に浮かんだ日本語の概念を、英語の単語や構文に変換する作業です。例えば、「昨日、友達と偶然会った」という状況を、英語の過去形や「run into」という句動詞に置き換える段階で時間がかかります。
- アクセス経路の長さ: 必要な単語や表現が、記憶の奥深く(長期記憶)に格納されているため、それを取り出すまでの神経回路の経路が長く、時間がかかります。
- ノイズによる干渉: 「発音はこれで合ってるかな」「この単語の使い方は正しいかな」といった自己評価や不安が、思考の流れに「ノイズ」として入り込み、スムーズな情報の引き出しを妨げます。
特に3つ目の「ノイズによる干渉」は、知識がある人ほど陥りがちな落とし穴です。完璧を求めすぎることで、かえって言葉が出にくくなっているのです。
「脳内キャッシュ」とは何か? 高速アクセス可能な情報の一時保管庫
この3つのボトルネックを解消する鍵が「脳内キャッシュ」です。キャッシュとは、コンピュータ用語で「頻繁に使うデータを高速にアクセスできる場所に一時的に保管する仕組み」を指します。
これを英語学習に当てはめると、日常会話で最も頻繁に使う表現や、自分がよく話すトピックに関する単語・構文を、意識的に「脳の手前」(ワーキングメモリに近い場所)に準備しておくという考え方になります。図書館の本をすべて暗記するのではなく、今日の会話で使えそうな数冊をあらかじめ机の上に広げておくようなイメージです。
キャッシュに保存される情報は、単なる単語の羅列ではありません。「I think…(私は〜だと思う)」という基本構文に、「it’s important to…(〜することは重要だ)」「from my experience…(私の経験では)」といった「頻出フレーズの塊(チャンク)」が、文脈や場面と結びついた状態で格納されます。これにより、日本語から英語への「変換」プロセスを大幅に短縮し、長い記憶の「アクセス経路」を迂回して、即座に言葉を取り出せるようになるのです。

ステップ1:あなたの「脳内キャッシュ」を設計する 高頻度情報の棚卸しと優先順位付け
前のセクションで、スピーキングの遅れは「知っていること」と「瞬間的に言えること」の間にある検索時間だと説明しました。この時間を短縮するカギが「脳内キャッシュ」です。しかし、闇雲にフレーズを覚えても効果は限定的です。効果的なキャッシュシステムの構築は、あなた自身の「使用頻度マップ」を作成することから始まります。ここでは、その具体的な設計手順を説明します。
自分だけの「使用頻度マップ」を作成する
どんなに優れた単語帳にも載っていない、あなただけの高頻度表現があります。それは、あなたの仕事、趣味、日常の会話で繰り返し使う言葉です。最初のステップは、この「自分だけの頻出表現」をリスト化することです。
- 自己紹介や自分の役職・業務内容の説明
- 会議で意見を求められたときの返答パターン
- 趣味の話をするときの決まり文句
- 食事や休憩の誘い、断り方
- よく聞かれる質問とその答え
ここで重要なのは、完璧な英文を書こうとしないことです。まずは日本語で「よく言うこと」「よく聞かれること」を書き出します。これがあなたの会話の基盤になります。
キャッシュ候補を選ぶ2つの基準:「汎用性」と「個人特異性」
リスト化した項目を、すべてキャッシュする必要はありません。優先度の高いキャッシュ候補を選ぶには、2つの基準を使います。
以下の2つの基準で、あなたのリストを評価してみましょう。両方の基準を満たすものが、最優先のキャッシュ候補です。
- 汎用性:誰とでも、どんな場面でも使える可能性が高い表現。
- 例:I think that…(私は〜だと思う), Could you tell me…?(〜を教えてもらえますか?), In my opinion…(私の意見では)
- 個人特異性:あなたの仕事、専門分野、趣味に特化した表現。
- 例:I’m in charge of the digital marketing strategy.(私はデジタルマーケティング戦略を担当しています), I’m a big fan of indie films.(インディーズ映画の大ファンです), The main challenge is the budget allocation.(主な課題は予算配分です)
「汎用性」の高い表現は会話の潤滑油となり、「個人特異性」の高い表現はあなたらしさを伝え、深い会話への入り口となります。両方のバランスを考えて選ぶことが、引っかからない会話を実現する設計図となります。
知識を「チャンク」で管理する:単語ではなく思考の塊を保存する
単語や単発のフレーズだけをキャッシュしても、会話の流れには乗れません。例えば、「I think」だけを覚えていても、その後が続かなければ意味がありません。ここで重要な概念が「チャンク」です。
チャンクとは、単語や文法の集まりではなく、「一連の思考の流れ」をひとまとまりにした情報の塊です。
単語レベルで一つずつ検索するのではなく、この「思考の塊」ごとに脳内から引き出すことで、発話の速度と流暢さが劇的に向上します。
「意見を述べる」という場面を想定します。
- 単語/フレーズ単位:I, think, that, is, a, good, idea.
- チャンク単位:I think that’s a good idea because it could solve the immediate issue.(それは良い考えだと思います。なぜなら、目の前の問題を解決できるからです。)
後者は「意見表明 → 理由の提示」という一連の流れをひとつの塊として保存しています。会話ではこの塊ごと引き出せるため、より自然で長い発話が可能になります。
あなたが作成した「使用頻度マップ」の各項目を、この「チャンク」の形に変換していきます。これが、無計画な暗記学習と、効果的な脳内キャッシュ構築の決定的な違いです。設計図なしに建材を積み上げるのではなく、会話という建築物の設計図に沿って、必要な部品(チャンク)を準備するのです。
次のステップでは、この設計図に基づいて、選んだ「チャンク」を実際に脳内に定着させる具体的なトレーニング方法について解説していきます。

ステップ2:情報に「強力なインデックス」を貼る 複数の検索経路から一瞬で引き出す技術
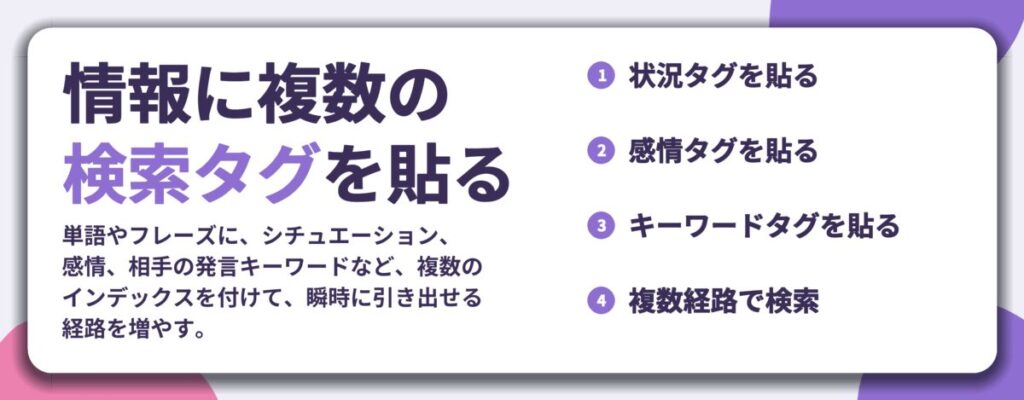
ステップ1で、あなただけの「脳内キャッシュ」に格納すべき高頻度情報を選び出しました。しかし、ただ単語やフレーズを覚えても、会話中にすぐに取り出せなければ意味がありません。このステップでは、キャッシュされた情報に、いかにして瞬時にアクセスするか、そのための「強力なインデックス(検索タグ)」の作り方を学びます。ネットの検索エンジンが複数のキーワードからページを探し出すように、あなたの脳内でも、1つの情報に複数の検索経路を確保するのです。
1つの情報に複数の「タグ」を付与する
多くの日本人学習者が陥りやすいのは、単語や表現を「日本語訳」という1本の鎖でしか結びつけていないことです。例えば、「apologize」を「謝る」とだけ関連づけて覚えています。これでは、「謝りたい!」という日本語が頭に浮かんだ時しか、この単語にアクセスできません。
効果的なインデックス作成とは、1つの情報に様々な角度から「タグ」を貼り付ける作業です。辞書のように一つの定義で覚えるのではなく、使用される場面、伴う感情、関連するキーワードなど、多面的な関連情報を結びつけることで、脳内の検索経路が格段に増えます。
単語「apologize」に貼り付けるインデックスの例:
- 状況タグ:ビジネスメール、会議での発言ミス、納期遅れの連絡
- 感情タグ:申し訳ない、焦り、責任を感じる、丁寧に対応したい
- 形式タグ:丁寧な表現、フォーマル、書き言葉でも話し言葉でも使える
- 関連キーワードタグ:sorry(よりカジュアル)、regret、mistake、forgive
- 構文タグ:apologize for ~ing / apologize to 人 for 事柄
シチュエーション・感情・キーワード:3方向からの検索経路を確保
では、具体的にどのような「タグ」を付ければ良いのでしょうか。特に強力なのは、「シチュエーション」「感情」「相手の発言キーワード」の3方向からのアプローチです。
- シチュエーション経路:「会議中に自分のデータに誤りを指摘された」という具体的な場面イメージが頭に浮かんだ時、自動的に「I must apologize for the error in the data.」というフレーズが候補として上がってくる状態です。
- 感情経路:「まずい、申し訳ないな」という感情(焦りや後悔)を感じた瞬間、その感情に「apologize」や「I’m so sorry」が結びついている状態です。感情は言葉より早く生まれるため、極めて強力なトリガーになります。
- キーワード経路:相手から「Sorry about that…」と言われた時、その「sorry」を聞いた瞬間に、「No, I should be the one to apologize.」のような返答が引き出せる状態です。相手の発言をきっかけに、連鎖的に適切な表現を検索できるようになります。
この3つの経路が確保されていれば、状況、自分の内面、相手の言葉のいずれからでも、適切な表現に最短でアクセスできます。これが「引っかからない会話」の基盤です。
日本語経由の迂回路を遮断する「直接インデックス」の作成法
スピーキングが遅くなる最大の原因は、「日本語で考え→英語に翻訳」という迂回路を通ることです。このプロセスを省略し、概念や状況イメージから直接英語を引き出す「直接インデックス」を作る必要があります。
単語やフレーズを覚える時、日本語訳ではなく、その言葉が表す「概念」や「状況」を心の中で映像化します。例えば「negotiate」なら、「会議室で向かい合い、条件を話し合っている二人」のイメージです。日本語の「交渉する」という文字は思い浮かべません。
そのイメージを見ながら、ネイティブの発音を聴き、自分でも声に出して「negotiate」と繰り返します。イメージ(概念)と英語の音声が直接結びつくまで練習します。
様々なシチュエーションを想定し、そのイメージから直接言葉を引き出す練習をします。「価格を下げてもらいたい時」「プロジェクトの期限を延ばしたい時」など、具体的な場面を思い浮かべ、そこから即座に「We need to negotiate the price.」と言えるように訓練します。この時、頭の中に日本語は存在しません。
この練習を積むことで、脳内の検索プロセスが「状況/概念 → 日本語 → 英語」から「状況/概念 → 英語」にショートカットされます。インデックスの質、つまり情報に貼られたタグの多様性と直接性が、情報の検索速度を決定するのです。単に暗記するのではなく、いかに豊かな関連情報で包み込むか。それが、知識を「使える武器」に変える鍵となります。

ステップ3:キャッシュを「書き込み」、アクセス経路を「最適化」する 毎日5分のシステムメンテナンス
これまでに、あなたの脳内キャッシュに保存すべき情報を選び出し、それらに複数の検索インデックスを貼り付けました。しかし、これらはシステムの設計図に過ぎません。会話で瞬時に引き出すためには、情報を確実にキャッシュに書き込み、アクセス経路を最適化する毎日のメンテナンスが必要です。このステップでは、学習ではなく「投資」と捉えられる負担の少ない維持管理法を紹介します。わずか5分の習慣が、会話の詰まりを劇的に減らします。
アクティブリコールで確実な書き込みを行う
キャッシュへの書き込みは、単にフレーズを聞いたり読んだりするだけでは不十分です。パソコンのメモリが電源を切るとデータを失うように、受動的なインプットだけでは情報は長期保存されません。必要なのは、記憶からの「能動的な引き出し」、すなわちアクティブリコールです。
例えば、「ステップ1」でリストアップした「自己紹介の型」をキャッシュする場合、テキストを眺めるのではなく、目を閉じて口に出して再現してみてください。「My name is…」から始まり、職業や趣味まで一連の流れを声にします。一語一句完璧でなくても構いません。重要なのは、頭の中の記憶を頼りに「再構築」しようとするプロセスそのものです。この努力が、情報へのアクセス経路を太く強固にします。
この練習は、新しいフレーズを覚える時だけでなく、既に知っているはずの表現でも効果的です。実際の会話で使えなかった表現こそ、アクティブリコールの対象にすべきです。
経路最適化の鍵を握る「エラーの分析」と「経路の再構築」
会話中に言葉に詰まることは、システムの弱点を発見する貴重なチャンスです。ここで大切なのは、単に「失敗した」と落ち込むのではなく、「どの検索インデックスが機能しなかったのか」を冷静に分析する姿勢です。
会話後に、詰まった瞬間を思い出します。何を言おうとしたのか、どの単語や構文が出てこなかったのかを簡潔にメモします。例えば、「『〜に詳しい』と言おうとして『knowledgeable』が出てこなかった」などです。
出てこなかった表現について、既存の検索インデックスを確認します。「knowledgeable」に「詳しい」という日本語タグしか貼っていなかったかもしれません。そこで、新しいインデックスを追加します。例えば、「expert」や「know a lot about」といった類義語、または「専門家」「精通している」といった別の日本語、さらには「スキルを説明する時の表現」というカテゴリタグを貼り直します。
追加した新しいインデックスを使って、アクティブリコールを行います。「専門家」というキーワードから「knowledgeable」を引き出せるか、「know a lot about」から「knowledgeable」を連想できるか、を練習します。複数の経路から同じ情報にアクセスできるようにすることが目標です。
この分析と再構築のプロセスを繰り返すことで、脆弱なインデックスが補強され、アクセス経路の冗長性が高まります。一つの経路がふさがっても、別の経路から情報を取り出せるようになるのです。
システムのパフォーマンスを測定する:詰まりの種類とその意味
「言葉に詰まる」という現象も、その原因によって対処法が異なります。あなたの脳内キャッシュシステムのパフォーマンスを測定し、弱点を特定するための指標として、以下の2種類の詰まりを意識してみてください。
| 詰まりの種類 | 具体的な状態 | 問題のキャッシュ領域 | 対処法の焦点 |
|---|---|---|---|
| 単語レベルでの詰まり | 「えーと、あの、『持続可能な』ってなんていうんだっけ…」 | 語彙キャッシュ (個々の単語や熟語) | その単語自体へのアクセス経路強化。類義語や反対語、イメージと結びつける。 |
| 構文・フレーズレベルでの詰まり | 「私はそれが…好きです…なぜなら…(文の組み立てが止まる)」 | 構文キャッシュ (文の型や接続表現) | 「I like it because…」といった文の骨組み(チャンク)の定着。状況に応じた型の引き出し練習。 |
自分がどちらの詰まりに多く遭遇するかによって、メンテナンスの重点を変えることができます。単語レベルの詰まりが多いなら、語彙のインデックス貼りとアクティブリコールを強化します。構文レベルの詰まりが多いなら、頻出する文の型を「チャンク」としてまとめて覚え、それらを組み合わせる練習に時間を割きます。
- 毎日5分で本当に効果があるのでしょうか?
-
大量のインプットを一度に行う「学習」と、既存のシステムを効率化する「メンテナンス」は別物です。5分間でできることは、例えば今日会話で使えなかった表現を1つ選び、そのアクセス経路を3つ増やすことです。この小さな積み重ねが、1週間後、1か月後には使える表現のネットワークを確実に広げ、検索時間の短縮という形で効果を発揮します。負担を感じない範囲で継続することが最も重要です。
- 新しい表現を覚えるのと、既存のキャッシュを磨くの、どちらを優先すべき?
-
スピーキングの瞬発力を高めることが目的であれば、既存のキャッシュの最適化を優先してください。すでに「知っている」情報を「瞬間的に言える」状態にすることが、会話の流暢さに直結します。新しい表現のインプットは、ステップ1で行った「自分にとっての高頻度情報」に絞り、それを確実にキャッシュ化するプロセスに組み込みましょう。質の高いキャッシュが100個ある方が、未整理の知識が1000個あるよりも会話では強力です。
このメンテナンスの本質は、英語学習を「知識の蓄積」から「情報検索システムの構築」へと転換することにあります。今日のわずかな詰まりを、明日の滑らかな会話への最適な投資材料として活用してください。

応用編:知的で流暢な会話を実現する「マルチレイヤーキャッシュシステム」
これまでのステップで、日常会話に必要な基本キャッシュの構築とメンテナンス方法を学びました。ここからは、単に言葉が出るだけの会話を超えて、知的で主導権を持ったコミュニケーションを実現する応用技術を解説します。これは、複数のキャッシュ層を積み重ね、さらに会話の流れを先読みする「マルチレイヤーキャッシュシステム」の構築です。
基本キャッシュの上に構築する「分野別専門キャッシュ」
日常会話用の基本キャッシュが安定したら、次は特定分野に特化した表現を追加しましょう。例えば、仕事で情報技術関連の話題を話す機会が多いなら、「情報技術分野専門キャッシュ」を作ります。ここには「implement(実装する)」「debug(デバッグする)」「scalable(拡張性のある)」といった専門用語や、プロジェクト進行に関する定型フレーズを格納します。
重要なのは、基本キャッシュとは独立した層として構築することです。これにより、状況に応じて最適なキャッシュ層を瞬時に切り替え、適切な専門性を持って話せるようになります。
- 基本レイヤー: 天気、食事、趣味、旅行など、万人共通の日常表現。
- 専門レイヤーA: 職種や専門分野(例: マーケティング、エンジニアリング)に特化した語彙。
- 専門レイヤーB: 深い趣味(例: ワイン、写真、投資)に関する詳細な表現。
このように層を分けることで、基本会話中に専門用語が不自然に混ざることを防ぎ、逆に専門的な議論の中で基礎的な言葉に詰まることもなくなります。
初心者のシステム: 1つの大きな「単語袋」に全てを詰め込み、会話中に必死に探す。分野が混ざり、検索に時間がかかる。
上級者のシステム: 基本、ビジネス、趣味など複数の整理された「引き出し」を持つ。会話のテーマに合わせて最適な引き出しを開け、中身はさらにインデックスで整理されているため、即座に取り出せる。
会話の展開を先読みする「予測キャッシュ」の活用
真に流暢な会話には、相手の言葉に反応するだけではなく、次に来るであろう話題や必要な表現を事前に準備する「予測」の技術が不可欠です。これを「予測キャッシュ」と呼びます。
例えば、相手が「I went to a new Italian restaurant last weekend.(先週末、新しいイタリアン料理店に行ったんだ)」と言ったとします。基本キャッシュしかない状態では「It was good?(良かった?)」と返すかもしれません。
しかし、予測キャッシュが働く上級者は、この発言を聞いた瞬間、脳内で関連する表現群を呼び出し待機させます。「料理の感想」「店の雰囲気」「値段」「オススメメニュー」といったサブトピックと、それに対応する単語(delicious, cozy, reasonable, must-try dish)が、次の発言を待つ間に準備されるのです。これにより、単純な質問ではなく「What did you think of their pasta? I’ve heard their ambiance is quite cozy.(パスタはどうだった? 雰囲気がとても居心地良さそうだと聞いたけど)」といった、会話を深掘りする返答が即座に可能になります。
キャッシュが豊富だと会話に余裕が生まれる本当の理由
キャッシュシステムが高度化する最大の利点は、単に言葉が速く出るようになること以上に、「考える余白」が生まれる点にあります。
初心者は、次の一言を探す「単語探し」に脳のリソースのほとんどを費やしています。これでは相手の話の細かいニュアンスを聞き取ったり、自分が次に何を話すべきか戦略を練ったりする「高次処理」にまで頭が回りません。
一方、マルチレイヤーキャッシュと予測キャッシュが機能する状態では、表現の検索と取り出しがほとんど自動化されます。解放された脳のリソースは、相手の表情や言外の意図を読み取ること、あるいは会話全体の流れをコントロールするために使えるようになります。これが、会話が「反応」から「主導」へと変わる瞬間です。受け身で答えるだけではなく、話題を導き、議論を深め、より印象的なコミュニケーションを創り出せるようになるのです。
システムが高度化すると、言葉のストックから次の言葉を引っ張り出す「処理」が軽減され、その分のリソースを「戦略」や「共感」といった、より人間らしい会話の核心に注げるようになります。